
Un seul GEEKOM A9 Mega, avec son AMD Ryzen AI Max+ 395 et 128 Go de mémoire, a fait tourner le modèle Qwen3.8-Flash-Next UD-Q4_K_XL de 111,4 Go à lui seul — sans deuxième machine ni cascade. Dans nos tests llama.cpp, il a généré 32,43 tokens/s avec un prompt court de 128 tokens, et tenait encore 15,45 tokens/s avec un prompt de 128K tokens.
Le compromis se situe dans l’attente avant le premier mot. À 128K tokens en entrée, le temps jusqu’au premier token (TTFT) a atteint 720,61 secondes, soit environ 12 minutes. La vitesse de décodage reste utilisable quand le contexte grandit ; c’est le traitement du prompt qui coûte du temps sur les longues entrées.
- 32,43 tokens/s en génération à 128 tokens d’entrée
- 15,45 tokens/s en génération à 128K tokens d’entrée
- 111,4 Go de modèle en 4 bits sur un seul mini PC de 128 Go
Chaque chiffre de cette page provient d’un enregistrement de test publié, avec la commande de lancement, les fichiers de modèle et la build logicielle. Vous pouvez consulter les relevés bruts dans notre dépôt GitHub de benchmarks ou le dataset sur Hugging Face.
Résultats complets : de 128 à 128K tokens
Nous avons mesuré le modèle à six longueurs d’entrée, d’un prompt de 128 tokens jusqu’à 128K tokens. La vitesse de décodage chute de 32,43 à 15,45 tokens/s sur cette plage — elle est à peu près divisée par deux — tandis que le temps jusqu’au premier token est multiplié par plusieurs centaines.
Vitesse de décodage selon la longueur de contexte
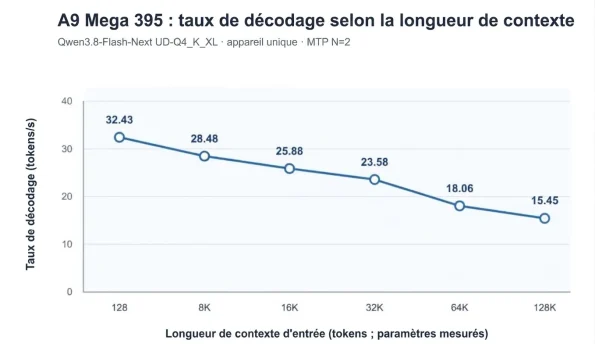
Les points sont espacés régulièrement par réglage de test, pour la lisibilité : leur distance horizontale n’est pas proportionnelle au nombre de tokens.
Tableau de données complet
| Longueur d’entrée (tokens) |
Longueur de sortie (tokens) |
TTFT (s) |
Prefill (tokens/s) |
Decode (tokens/s) |
Bout en bout (s) |
Mémoire (Go) |
|---|---|---|---|---|---|---|
| 128 | 5 000 | 0,97 | 132,22 | 32,43 | 155,15 | 101,61 (+30,17) |
| 8K | 1 604 | 26,96 | 303,83 | 28,48 | 83,28 | 101,71 (+30,87) |
| 16K | 2 617 | 58,33 | 280,89 | 25,88 | 159,45 | 101,84 (+31,89) |
| 32K | 2 695 | 112,14 | 292,21 | 23,58 | 226,43 | 101,80 (+30,96) |
| 64K | 1 965 | 283,41 | 231,24 | 18,06 | 392,22 | 102,14 (+31,54) |
| 128K | 5 000 | 720,61 | 181,89 | 15,45 | 1 044,24 | 102,50 (+32,56) |
Source : relevés de test A9 Mega 395 et test-records.csv sur GitHub. La mémoire est indiquée comme mémoire GPU, plus la part déchargée vers la RAM système entre parenthèses.
Comment lire ces chiffres
- TTFT (temps jusqu’au premier token) : le temps d’attente après l’envoi d’un prompt, avant l’apparition du premier mot. Il augmente avec la longueur du prompt.
- Prefill : la vitesse à laquelle le modèle lit votre prompt, en tokens par seconde.
- Decode : la vitesse à laquelle le modèle écrit sa réponse, en tokens par seconde. C’est la vitesse que vous observez pendant que le texte défile.
- Temps de bout en bout : le TTFT plus le temps de génération de ce test. La longueur de sortie variait d’un test à l’autre (de 1 604 à 5 000 tokens) : comparez donc la vitesse de décodage et le TTFT d’une ligne à l’autre, pas le temps de bout en bout.
Contexte long : « ça tourne » vs « combien de temps vous attendez »
Les longs prompts ne cassent pas cette configuration, mais ils font patienter. À 128K tokens en entrée, le modèle écrit encore à 15,45 tokens/s, plus vite que la plupart des gens ne lisent. Avant d’écrire quoi que ce soit, il doit toutefois traiter l’intégralité du prompt.
| Longueur d’entrée | Temps jusqu’au premier token | Vitesse de décodage |
|---|---|---|
| 128 tokens | moins d’une seconde | 32,43 tokens/s |
| 8K | environ 27 secondes | 28,48 tokens/s |
| 32K | environ 1 min 52 s | 23,58 tokens/s |
| 64K | environ 4 min 43 s | 18,06 tokens/s |
| 128K | environ 12 minutes | 15,45 tokens/s |
Ce que cela signifie en pratique :
- Chat, aide au code et documents courts (jusqu’à quelques milliers de tokens) : la configuration répond vite, le premier mot arrive en quelques secondes et le texte défile à 28–32 tokens/s.
- Entrées moyennes autour de 32K tokens, comme un long rapport ou un extrait de codebase de taille moyenne : comptez environ deux minutes d’attente avant que la réponse démarre.
- Très longues entrées proches de 128K tokens : c’est du travail par lots. Lancez la tâche, faites autre chose, et revenez à une réponse complète générée à un rythme lisible.
La vitesse de décodage baisse quand le contexte grandit, sur n’importe quel appareil, et ce test suit la même logique. Le chiffre à anticiper pour les longs documents, c’est le TTFT, pas la vitesse de décodage.
Comment un modèle de 111,4 Go tient dans 128 Go
Le modèle tourne sur un seul A9 Mega 395 parce que l’essentiel réside en mémoire accessible au GPU et qu’une partie vit dans la RAM système.
Répartition de la mémoire
Pendant les tests, l’utilisation de la mémoire GPU est restée entre 101,61 et 102,50 Go. De 30,17 à 32,56 Go supplémentaires étaient déchargés vers la RAM système (CPU) ; cette part contient les données d’embedding N-gram du modèle. Au total, cela fait de 131,78 à 135,06 Go, soit plus que les 128 Go installés.
Le total peut dépasser la mémoire physique parce que la portion déchargée peut utiliser la mémoire virtuelle du système (swap). Ce sont les relevés tels que mesurés, et nous les publions en l’état. Les poids du modèle, le modèle brouillon de 2,8 Go, la surcharge du runtime et le cache de contexte (KV) se disputent tous cet espace : la capacité mémoire détermine donc à la fois la taille du modèle et la longueur de contexte qu’un seul appareil peut servir.
Pourquoi le 4 bits UD-Q4_K_XL
La quantification stocke les poids du modèle avec moins de bits, ce qui réduit les besoins en mémoire au prix d’une certaine fidélité. Pour ce modèle, l’analyse de quantification d’Unsloth chiffre le compromis :
| Quantification GGUF | Taille disque (Go) | Top-1 recovery (%) | KLD moyen |
|---|---|---|---|
| UD-Q2_K_XL | 78,9 | 82,715 | 0,224607 |
| UD-IQ4_XS | 93,7 | 89,554 | 0,083630 |
| UD-Q4_K_XL (testé) | 111,3 | 92,255 | 0,046893 |
| UD-Q5_K_XL | 158,3 | 93,680 | 0,030415 |
| Q8_0 | 188,2 | 94,122 | 0,026574 |
Source : chiffres publiés par Unsloth pour les quantifications de Qwen3.8-Flash-Next. Le « Top-1 recovery » mesure la fréquence à laquelle le modèle quantifié choisit le même token de premier choix que la référence ; un KLD moyen plus bas signifie des distributions de sortie plus proches. Aucun des deux n’est un score de précision sur une tâche.
Le UD-Q4_K_XL conserve environ 92 % de Top-1 recovery. Passer en Q5 ou Q8 n’ajoute qu’1 à 2 points tout en rendant le fichier 1,4 à 1,7 fois plus gros, ce qui ne tient plus dans un appareil de 128 Go. Descendre en 2 bits économise environ 32 Go mais fait chuter le Top-1 recovery sous 83 %. Ces chiffres ne valent que pour ce modèle et ces quantifications.
Ce qu’apporte le MTP
Le test utilisait la prédiction multi-token (MTP) : un petit modèle brouillon de 2,8 Go propose jusqu’à deux tokens d’avance (--spec-draft-n-max 2), et le modèle principal les vérifie. C’est un montage de décodage spéculatif standard dans llama.cpp. Nous n’avons pas enregistré de test sans MTP pour ce modèle : nous ne citons donc aucun gain de vitesse chiffré.
À lire aussi : Comment faire tourner Qwen3.8 Flash Next en local sur un mini PC Ryzen AI Max+ 395
À qui s’adresse cette configuration (et à qui non)
Cette configuration convient aux personnes qui veulent faire tourner en local un modèle de la classe des 100 Go sur une seule machine compacte, et qui acceptent de longues attentes sur les prompts très longs.
Vous utilisez plutôt l’A9 Mega 388 (64 Go) ? Le 388 ne peut pas contenir ce modèle de 111,4 Go à lui seul. Dans nos relevés, il a fait tourner le même modèle en cascade sur deux appareils (avec un second A9 Mega), à 30,76 tokens/s avec un prompt de 128 tokens. Voir la page produit A9 Mega pour les deux configurations.
Reproduire ce benchmark
Tout ce qu’il faut pour relancer ce test est public : les versions matérielles et logicielles, les fichiers de modèle, la commande de lancement exacte et les scripts d’installation.
Configuration de test
| Élément | Configuration |
|---|---|
| Appareil | GEEKOM A9 Mega 395 |
| Processeur | AMD Ryzen AI Max+ 395 (16 cœurs / 32 threads) |
| Partie graphique | AMD Radeon 8060S |
| Mémoire | 128 Go, bande passante 256 Go/s |
| Système d’exploitation | Ubuntu 26.04 |
| Pilote graphique / ROCm | 31.50.0.0 / ROCm 10.0.0 |
| Moteur d’inférence | llama.cpp, build b10909-mix-bea84f7 (Unsloth) |
| Modèle principal | Qwen3.8-Flash-Next-UD-Q4_K_XL.gguf, 111,4 Go en quatre shards |
| Modèle brouillon | mtp-Qwen3.8-Flash-Next-Q4_K_M.gguf, 2,8 Go, MTP avec N=2 |
| Réglages clés | -c 256000, -fa on, -b 4096 -ub 2048, -np 1, un seul appareil (pas de --rpc) |
Commande de lancement
C’est la commande enregistrée pendant les tests. Les chemins de fichiers sont ceux de notre machine de test ; adaptez-les à l’endroit où vous stockez le modèle.
./llama-server -m /home/user/mode/Qwen3.8-Flash-Next-UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf -ngl 99 -c 256000 -b 4096 -ub 2048 -fa on -np 1 --host 127.0.0.1 --port 8080 --metrics -lv 4 -md /home/user/mode/Qwen3.8-Flash-Next-UD-Q4_K_XL/mtp-Qwen3.8-Flash-Next-Q4_K_M.gguf -ngld 99 --spec-type draft-mtp --spec-draft-n-max 2Scripts d’installation et de téléchargement
Sur un A9 Mega 395 en Ubuntu 26.04 x86-64 natif, lancez ces commandes depuis la racine du dépôt de benchmarks :
bash scripts/setup-ubuntu-26.04.sh
python3 scripts/download-models.py flagship
python3 scripts/download-llama-cpp.py 395
Le script d’installation met en place les prérequis système, un environnement CLI Hugging Face et ROCm 10.0.0. Le script de téléchargement récupère les quatre shards du modèle et le modèle brouillon MTP depuis Hugging Face, et enregistre le commit source. Les téléchargements sont volumineux : choisissez un disque avec assez d’espace libre. Vérifiez vos versions de pilote et de ROCm avant de comparer vos résultats aux nôtres.
Les questions et comptes rendus de reproduction sont les bienvenus en GitHub Issues. Merci d’indiquer le fichier de modèle, la commande de lancement et l’appareil utilisés.
Limites connues
Ces résultats décrivent une configuration enregistrée. Voici ce qu’ils ne couvrent pas.
- Contexte testé jusqu’à 128K. La commande autorise 256 000 tokens, mais aucun résultat à 256K sur un seul appareil n’a été enregistré pour ce modèle sur l’A9 Mega 395.
- Certaines conditions de test ne sont pas encore publiées. Version du BIOS, pilote NPU et profil d’alimentation sont encore marqués « à confirmer » dans l’archive de test.
- Les résultats dépendent de la configuration. Une autre build de llama.cpp, un autre système, un autre fichier de modèle, une autre longueur de contexte, un autre profil d’alimentation ou une charge de fond différente peuvent changer les chiffres. Traitez ces données comme une référence, pas comme une garantie pour chaque unité.
- « Local » ne veut pas dire hors ligne dès le premier jour. Les modèles, logiciels et dépendances doivent être téléchargés et configurés avant de déconnecter l’appareil d’Internet.
- La sortie du modèle peut être fausse. Ne vous fiez pas au texte généré seul pour des décisions médicales, juridiques, financières ou critiques pour la sécurité.
FAQ
L’A9 Mega 395 peut-il faire tourner Qwen3.8-Flash-Next sur un seul appareil ?
Oui. La version UD-Q4_K_XL de 111,4 Go a tourné sur un seul A9 Mega 395 doté de 128 Go de mémoire, sans deuxième appareil ni cascade. Nous avons enregistré des résultats d’un prompt de 128 tokens jusqu’à 128K tokens en entrée, avec llama.cpp et un modèle brouillon MTP de 2,8 Go.
Quelle vitesse pour Qwen3.8-Flash-Next sur le Ryzen AI Max+ 395 ?
Dans nos tests, il a généré 32,43 tokens/s avec un prompt de 128 tokens, 23,58 tokens/s à 32K et 15,45 tokens/s à 128K. Ces chiffres proviennent de la build llama.cpp b10909-mix-bea84f7, sous Ubuntu 26.04 avec ROCm 10.0.0 et MTP réglé sur N=2.
Combien de mémoire utilise-t-il ?
L’utilisation de la mémoire GPU allait de 101,61 à 102,50 Go, avec 30,17 à 32,56 Go supplémentaires déchargés vers la RAM système pour les données d’embedding N-gram du modèle. Le total combiné peut dépasser les 128 Go installés, car la part déchargée peut recourir au swap système.
Le GEEKOM A9 Mega 395 prend-il en charge un contexte de 256K ?
La commande de lancement fixe une fenêtre de contexte de 256 000 tokens, mais nos tests sur un seul appareil s’arrêtent à 128K. Nous n’avons aucun résultat mesuré à 256K pour cette configuration : nous ne revendiquons donc pas de performances à 256K sur un seul A9 Mega 395.
Puis-je reproduire ces résultats ?
Oui. Le dépôt GitHub publie la commande de lancement, la build llama.cpp, les noms des fichiers de modèle et les scripts d’installation pour Ubuntu 26.04. Adaptez les chemins de fichiers de la commande à votre système, et vérifiez vos versions de pilote et de ROCm avant de comparer les résultats.