
Quand votre objectif principal est de faire tenir un gros modèle sur une machine abordable, la mémoire unifiée peut compter davantage que la VRAM dédiée. À l’inverse, la VRAM dédiée garde l’avantage dès qu’il vous faut des réponses rapides, beaucoup de débit, ou plusieurs utilisateurs simultanés sur le même modèle. Pour bien choisir, ne demandez pas quel type de mémoire est « le meilleur » dans l’absolu : la vraie question — mémoire unifiée ou VRAM pour un LLM en local — est de savoir ce dont votre charge de travail a réellement besoin. Commencez par repérer si c’est la capacité ou la bande passante qui vous bloque. Cela compte surtout si vous cherchez à faire tourner un LLM en local sur une petite machine abordable — un mini PC, un ordinateur portable ou un compact — où vous ne pouvez pas simplement glisser une carte graphique plus puissante.
VRAM dédiée et mémoire unifiée : deux architectures différentes
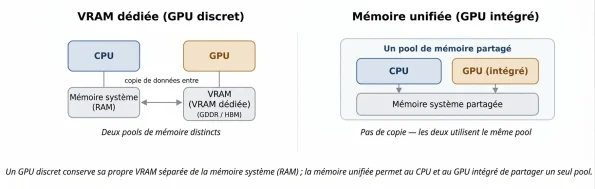
La VRAM (mémoire vidéo dédiée) est une mémoire physiquement rattachée à une carte graphique séparée. Un GPU de bureau n’utilise que de la mémoire GDDR ou HBM : il peut donc déplacer les données très vite, sans entrer en concurrence avec Windows, les onglets du navigateur ou vos autres programmes. C’est pourquoi un GPU dédié, capable d’assumer la charge, reste le meilleur choix quand le temps de réponse est déterminant.
La mémoire unifiée fonctionne autrement. Le processeur et une puce graphique intégrée se partagent un même pool de mémoire système. Les graphiques intégrés Intel, les nouveaux APU AMD et processeurs Ryzen AI, ainsi que les puces d’Apple reposent tous sur ce principe — même si celui d’Apple fait figure d’exception à haute bande passante, plus proche d’une carte graphique que des composants PC grand public dont parle cet article.
Il y a un vrai compromis. La mémoire unifiée est souvent de la LPDDR5X ou de la DDR5, pas de la GDDR ni de la HBM. Même si la capacité totale paraît généreuse, sa bande passante est bien inférieure à celle d’une carte graphique dédiée. En résumé : la mémoire unifiée offre plus d’espace, tandis que la VRAM dédiée alimente le GPU plus vite.
| Type de mémoire | Où elle réside | Principal avantage | Principal inconvénient |
|---|---|---|---|
| VRAM dédiée | Carte graphique séparée, VRAM réservée au GPU | Forte bande passante et génération de tokens rapide | Très coûteuse en grande capacité |
| Mémoire unifiée | Un seul pool partagé entre le CPU et le GPU intégré | Plus d’espace utilisable dans un petit système | Moins de bande passante, génération plus lente |
Combien de mémoire un modèle local consomme-t-il vraiment ?
Il ne suffit pas de prévoir la place des poids du modèle. Pour exécuter le modèle, votre machine a aussi besoin d’espace pour le système d’exploitation, les tampons de travail temporaires, le cache KV, l’allocation graphique et le logiciel qui fait tourner le modèle. Une fois tout le reste ajouté au fichier du modèle, l’ensemble ne tient souvent plus.
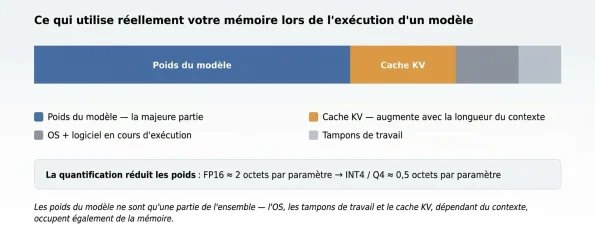
Le nombre de paramètres et le format de stockage déterminent le poids. En FP16, chaque paramètre occupe environ deux octets ; en INT4 ou Q4, environ un demi-octet avant surcharge. C’est la quantification qui rend cela possible : elle réduit la taille du fichier de poids pour trouver un compromis entre qualité, consommation mémoire et vitesse, viable sur du matériel domestique.
Le cache KV mérite lui aussi votre attention. Le modèle peut « se souvenir » de ce qui précède parce qu’il stocke les informations de la conversation. Chaque nouveau token généré et la longueur du contexte font grossir ce cache. Un prompt court ne change pas grand-chose au calcul, mais un long document, une longue conversation ou un workflow de recherche documentaire peuvent consommer bien plus de mémoire qu’on ne l’imagine. C’est pourquoi la longueur de contexte compte presque autant que le modèle lui-même quand on évalue la mémoire nécessaire.
Pourquoi plus de mémoire peut compter davantage que la VRAM
Avant que la vitesse d’un modèle n’entre en jeu, encore faut-il qu’il tienne. S’il ne tient pas dans la mémoire accessible au matériel graphique, soit vous ne pouvez pas l’exécuter, soit vous devez renvoyer une partie du travail vers le stockage et le CPU, bien plus lents. Aucune de ces deux issues n’est satisfaisante pour un usage quotidien.
La mémoire unifiée change la donne sur ce point. La plupart des GPU dédiés grand public embarquent 8, 12, 16 ou 24 Go de VRAM. Pour disposer de 64 ou 128 Go de VRAM dédiée, il faut généralement du matériel de datacenter, plusieurs GPU ou une station de travail très onéreuse. Un mini PC à mémoire unifiée peut offrir bien plus de capacité partagée dans un format compact et silencieux — mais la part réservée au GPU intégré doit parfois être définie dans le firmware.
Un test concret mené par AMD montre ce que cela permet. Sur un système Ryzen AI Max+ 395 — nom de code « Strix Halo » — doté de 128 Go de mémoire unifiée, 64 Go ou plus de ce pool peuvent être attribués au GPU intégré via le BIOS. C’est suffisant pour charger un modèle de 122 milliards de paramètres (une architecture Mixture-of-Experts) qu’aucune carte graphique grand public ne peut contenir, en partageant un seul pool de mémoire entre le CPU et le GPU intégré ; lorsque le modèle déborde de la part allouée au GPU, le travail est automatiquement réparti entre CPU et GPU. C’est lent — environ 8 à 9 tokens par seconde — mais ça fonctionne, ce dont un GPU de jeu de 24 Go est tout simplement incapable. Une précision s’impose : il s’agit d’une conception particulière, à haute bande passante, avec un bus mémoire 256 bits à environ 215 Go/s. Un APU de mini PC classique utilise un bus plus étroit, 128 bits à environ 90 Go/s : il n’atteindra donc pas ces vitesses, même avec la même quantité de RAM installée.
La capacité prime surtout quand vous voulez un assistant privé qui reste sur votre réseau, une recherche documentaire à long contexte, ou de la marge pour tester un modèle plus grand sans acheter une armoire de cartes graphiques. Pour une seule tâche en solo, une vitesse réduite peut suffire — alors que le modèle ne tiendrait tout simplement pas sur votre GPU actuel.
Pourquoi la VRAM dédiée reste plus rapide
Une fois les poids chargés, c’est la bande passante qui devient la limite décisive. Pendant la génération, la machine lit encore et encore les données du modèle en mémoire. Plus ces données circulent vite, plus le texte s’affiche vite. En règle générale, la vitesse de génération est liée à la bande passante mémoire disponible divisée par la taille des données de modèle lues — le résultat exact dépendant du runtime, du contexte, du processeur et de l’architecture du GPU.
La GDDR et la HBM d’un GPU séparé peuvent offrir plusieurs centaines de Go par seconde, voire bien davantage sur du matériel professionnel. La bande passante de la mémoire unifiée est nettement inférieure. Un même modèle peut se charger sur les deux, mais la machine à VRAM dédiée paraîtra bien plus réactive.
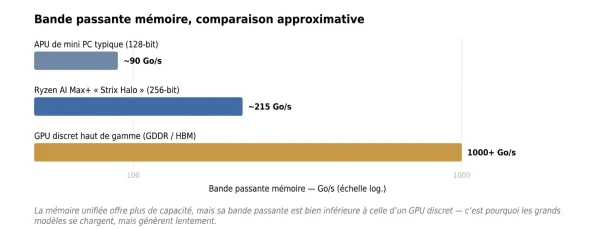
À l’usage en temps réel, la différence saute aux yeux. Pour un long résumé, un paquet de notes ou une tâche documentaire hors ligne, un gros modèle qui ne produit que quelques tokens par seconde en mémoire partagée peut suffire. En revanche, l’échange devient vite pénible quand il vous faut une réponse immédiate. La VRAM dédiée reste la meilleure option pour le travail interactif, les utilisateurs multiples simultanés et la génération de texte intensive et continue.
Le compromis est simple à cerner : la mémoire unifiée, c’est le coût et la capacité ; la VRAM dédiée, c’est la vitesse et la bande passante.
Quelle limite vous bloque : « ça tient » ou « c’est rapide » ?
C’est votre goulot d’étranglement qui doit décider. Si les modèles que vous visez ne tiennent pas, disposer de plus d’espace vaut mieux qu’un GPU plus rapide mais à court de VRAM. Si vos modèles tiennent déjà mais que chaque réponse est trop longue à venir, c’est de bande passante que vous avez besoin.
Lorsqu’une seule personne travaille en local, que la confidentialité compte, que les moyens sont comptés et que des temps de réponse modérés vous conviennent, la mémoire unifiée est généralement le meilleur choix. Elle s’impose aussi quand vous voulez un petit système discret et sobre en énergie, par exemple une machine qui reste allumée toute la journée.
Pour des services professionnels, plusieurs utilisateurs en même temps, de longues générations fréquentes, ou tout workflow où attendre chaque réponse coûte du temps, la VRAM dédiée est le choix le plus sûr. Parfois, un modèle plus petit sur un GPU dédié rapide rend mieux service en interactif qu’un modèle bien plus gros qui tient tout juste en mémoire partagée.
Ce que cela implique pour les mini PC
Les petits PC x86 d’aujourd’hui offrent un bon compromis. Un mini PC moderne à base de Ryzen utilise la mémoire système partagée, fait tourner les logiciels Windows ou Linux habituels et réclame moins de place et d’énergie qu’une station de travail à GPU séparé. Vous perdez un peu de bande passante graphique, mais vous gagnez potentiellement l’espace nécessaire pour exécuter un modèle qui ne tiendrait pas sur un GPU de jeu de 8 ou 12 Go.
Un mini PC peut parfaitement servir d’assistant personnel à la maison, de petit service de recherche documentaire ou de machine toujours allumée, sans écran ni refroidissement bruyant. Il ne remplace pas un serveur puissant capable de traiter de nombreuses requêtes à la fois. Mais il vous permet de garder un modèle utile à portée de main, sans envoyer toutes vos requêtes vers le cloud.
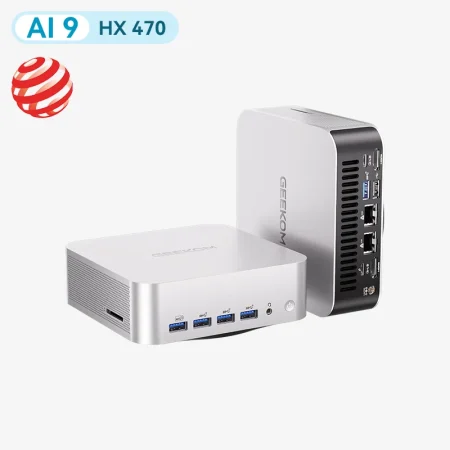
Le GEEKOM A9 Max illustre bien la version quotidienne de cette idée. Bâti sur le Ryzen AI 9 HX 370 avec un GPU intégré Radeon 890M, il peut accueillir jusqu’à 128 Go de DDR5 selon les configurations.
Ce n’est pas l’une des machines à haute bande passante décrites plus haut : il est donc le plus à l’aise avec des modèles petits à moyens — environ 7 à 14 milliards de paramètres — à des vitesses exploitables, comme boîtier discret et peu gourmand que vous laissez allumé pour un assistant privé ou un outil de recherche documentaire. Son plafond mémoire élevé reste utile : il laisse de la place pour charger un modèle plus gros en parallèle de vos applications quotidiennes, même si ce modèle tourne lentement. Avant l’achat, vérifiez la configuration exacte disponible, car la mémoire installée et les disponibilités peuvent évoluer.
FAQ
La mémoire unifiée peut-elle remplacer un GPU dédié ?
Vous pouvez l’utiliser à la place d’un GPU dédié si faire tenir un modèle en local compte plus que viser l’option la plus rapide, et si une sortie plus lente ne vous dérange pas. Comme elle n’a pas la bande passante d’un GPU dédié, n’attendez pas la même vitesse en travail interactif avec le même modèle.
Un modèle 70B peut-il tourner sur un mini PC avec 64 Go ou 128 Go de mémoire ?
Cela dépend de la quantification, du contexte utilisé et de la mémoire disponible pour le cache KV. Une capacité de 64 Go peut être insuffisante dans certaines configurations, tandis que 128 Go offrent davantage de marge. À titre indicatif, un fichier 70B en Q4 pèse environ 39 Go d’après les recommandations publiées par Ollama pour Stable Beluga — mais le fichier du modèle n’est pas la seule chose à faire tenir. Pour choisir une capacité adaptée à votre usage, consultez notre guide de combien de RAM avez-vous besoin. Côté LLM en local, retenez qu’il faut aussi tenir compte de la bande passante mémoire et de la vitesse d’inférence.
Côté mémoire, la longueur de contexte consomme-t-elle plus que la taille du modèle ?
Cela peut arriver, surtout lors de longues conversations ou quand vous devez fouiller beaucoup de documents. Les poids du modèle gardent la même taille, mais le cache KV ne cesse de grossir à mesure que le contexte et la sortie s’allongent. Prévoyez plus que le simple nombre de paramètres affiché sur la fiche du modèle : pensez aux types de prompts que vous utiliserez réellement.
La vitesse des mini PC est-elle suffisante pour un usage domestique ?
Elle suffit pour de nombreuses tâches en solo : résumés, aide légère au code, discussion privée, recherche documentaire. Les gros modèles qui partagent la mémoire produiront généralement le texte plus lentement que des modèles de même taille s’appuyant sur une carte graphique à haute bande passante.
Un PC peut-il utiliser à la fois mémoire unifiée et VRAM dédiée ?
Oui. Un ordinateur équipé d’un GPU dédié dispose de RAM système pour le CPU et de VRAM dédiée pour le GPU. Certains systèmes ont aussi des graphiques intégrés. Comme le logiciel qui exécute le modèle principal doit toujours pouvoir accéder à la mémoire, disposer de beaucoup de RAM système n’agrandit pas automatiquement la VRAM d’une carte graphique séparée.
La bonne approche : partir de la capacité quand c’est elle, la limite
Quand c’est le manque d’espace qui vous empêche d’exécuter le modèle voulu, la mémoire unifiée prime. Elle donne accès à des modèles privés plus gros, à des contextes plus longs et à de petits services locaux sur un mini PC pour un prix raisonnable. La VRAM dédiée prime, elle, quand le modèle tient et que vous avez besoin d’une sortie rapide et stable.
La plupart des personnes qui font tourner des modèles chez elles avec des moyens limités trouveront la mémoire unifiée plus utile, à condition d’accepter de sacrifier un peu de bande passante. Une fois le modèle et la taille choisis, assurez-vous d’avoir assez de mémoire pour le système d’exploitation et votre travail quotidien. Ce raisonnement vaut mieux que de décréter que la mémoire unifiée ou la VRAM serait « la meilleure » dans l’absolu.